17 記述統計表の作り方
本章では、janitor パッケージ、dplyr パッケージ、gtsummary パッケージ、rstatix パッケージ、R の基本パッケージ(以下、ベース R)を使って、データを要約したり、記述統計表を作成したりする方法を紹介します。
本章では、元になるテーブルの作成方法を、見やすい表の作り方章では、表をみやすくフォーマットして印刷する方法をそれぞれ説明しています。
各パッケージはコードの簡素化、出力の種類、印刷出力の品質などの面で長所と短所を備えています。本章を参考にして、ご自身の使い方に合ったアプローチをお選びください。
集計表やクロス集計表を作成する際には、いくつかの選択肢があります。例えば、コードの容易さ、カスタマイズ性、出力時に要求されること(R コンソールへの出力、データフレームとしての出力、「きれいな」 .png/.jpeg/.html 画像としての出力)、後処理のしやすさなど、いくつかの要素が考えられます。次の点を考慮して、自分の状況に合ったツールを選択してください。
-
janitor パッケージの
tabyl()は、集計表やクロス集計表を作成し、「加工する」ために使います。 -
rstatix パッケージの
get_summary_stats()を使うと、複数の列やグループの要約統計量を数値化したデータフレームを簡単に生成できます。 - より複雑な統計処理、データフレーム出力の整理、または
ggplot()用データの準備には、dplyr パッケージのsummarise()やcount()を使います。 -
gtsummary パッケージから
tbl_summary()を使用して、公表用の詳細な表を作成します。 - 上記のパッケージを利用できない場合は、ベース R の
table()を使用してください。
17.1 準備
パッケージの読み込み
以下のコードを実行すると、分析に必要なパッケージが読み込まれます。このハンドブックでは、パッケージを読み込むために、pacman パッケージの p_load() を主に使用しています。p_load() は、必要に応じてパッケージをインストールし、現在の R セッションで使用するためにパッケージを読み込む関数です。また、すでにインストールされたパッケージは、R の基本パッケージである base の library() を使用して読み込むこともできます。R のパッケージについては R の基礎の章を参照してください。
pacman::p_load(
  rio,          # ファイルインポート
  here,         # ファイルロケータ
  skimr,        # データの概要を把握
  tidyverse,    # データ管理とggplot2描画
  gtsummary,    # 要約統計量と検定
  rstatix,      # 要約統計量と統計的検定
  janitor,      # 表に合計値とパーセンテージを追加
  scales,       # 割合をパーセンテージに簡単に変換
  flextable, # 表をきれいな画像に変換
  appliedepidata # 本ハンドブックで使用するサンプルデータ
  )
データのインポート
エボラ出血熱の流行をシミュレートしたデータセットをインポートします。appliedepidata::get_data(name = "linelist_cleaned_rds") で直接読み込めます(詳細はハンドブックとデータのダウンロードのページを参照)。
# ラインリストをインポート
linelist <- appliedepidata::get_data(name = "linelist_cleaned_rds")
linelist の最初の 50 行を以下に表示します。
17.2 データを閲覧する
skimr パッケージ
skimrパッケージを使用すると、データセット内の各変数の概要を、詳細かつ見た目にわかりやすいで把握することができます。 skimr の詳細については、 github ページをご覧ください。
以下では、関数 skim() を linelist データフレーム全体に適用しています。データフレームの概要とすべての列の概要が(データ型別に)生成されます。
## データセット内の各変数の情報を取得
skim(linelist)| Name | linelist |
| Number of rows | 5888 |
| Number of columns | 30 |
| _______________________ | |
| Column type frequency: | |
| character | 13 |
| Date | 4 |
| factor | 2 |
| numeric | 11 |
| ________________________ | |
| Group variables | None |
Variable type: character
| skim_variable | n_missing | complete_rate | min | max | empty | n_unique | whitespace |
|---|---|---|---|---|---|---|---|
| case_id | 0 | 1.00 | 6 | 6 | 0 | 5888 | 0 |
| outcome | 1323 | 0.78 | 5 | 7 | 0 | 2 | 0 |
| gender | 278 | 0.95 | 1 | 1 | 0 | 2 | 0 |
| age_unit | 0 | 1.00 | 5 | 6 | 0 | 2 | 0 |
| hospital | 0 | 1.00 | 5 | 36 | 0 | 6 | 0 |
| infector | 2088 | 0.65 | 6 | 6 | 0 | 2697 | 0 |
| source | 2088 | 0.65 | 5 | 7 | 0 | 2 | 0 |
| fever | 249 | 0.96 | 2 | 3 | 0 | 2 | 0 |
| chills | 249 | 0.96 | 2 | 3 | 0 | 2 | 0 |
| cough | 249 | 0.96 | 2 | 3 | 0 | 2 | 0 |
| aches | 249 | 0.96 | 2 | 3 | 0 | 2 | 0 |
| vomit | 249 | 0.96 | 2 | 3 | 0 | 2 | 0 |
| time_admission | 765 | 0.87 | 5 | 5 | 0 | 1072 | 0 |
Variable type: Date
| skim_variable | n_missing | complete_rate | min | max | median | n_unique |
|---|---|---|---|---|---|---|
| date_infection | 2087 | 0.65 | 2014-03-19 | 2015-04-27 | 2014-10-11 | 359 |
| date_onset | 256 | 0.96 | 2014-04-07 | 2015-04-30 | 2014-10-23 | 367 |
| date_hospitalisation | 0 | 1.00 | 2014-04-17 | 2015-04-30 | 2014-10-23 | 363 |
| date_outcome | 936 | 0.84 | 2014-04-19 | 2015-06-04 | 2014-11-01 | 371 |
Variable type: factor
| skim_variable | n_missing | complete_rate | ordered | n_unique | top_counts |
|---|---|---|---|---|---|
| age_cat | 86 | 0.99 | FALSE | 8 | 0-4: 1095, 5-9: 1095, 20-: 1073, 10-: 941 |
| age_cat5 | 86 | 0.99 | FALSE | 17 | 0-4: 1095, 5-9: 1095, 10-: 941, 15-: 743 |
Variable type: numeric
| skim_variable | n_missing | complete_rate | mean | sd | p0 | p25 | p50 | p75 | p100 |
|---|---|---|---|---|---|---|---|---|---|
| generation | 0 | 1.00 | 16.56 | 5.79 | 0.00 | 13.00 | 16.00 | 20.00 | 37.00 |
| age | 86 | 0.99 | 16.07 | 12.62 | 0.00 | 6.00 | 13.00 | 23.00 | 84.00 |
| age_years | 86 | 0.99 | 16.02 | 12.64 | 0.00 | 6.00 | 13.00 | 23.00 | 84.00 |
| lon | 0 | 1.00 | -13.23 | 0.02 | -13.27 | -13.25 | -13.23 | -13.22 | -13.21 |
| lat | 0 | 1.00 | 8.47 | 0.01 | 8.45 | 8.46 | 8.47 | 8.48 | 8.49 |
| wt_kg | 0 | 1.00 | 52.64 | 18.58 | -11.00 | 41.00 | 54.00 | 66.00 | 111.00 |
| ht_cm | 0 | 1.00 | 124.96 | 49.52 | 4.00 | 91.00 | 129.00 | 159.00 | 295.00 |
| ct_blood | 0 | 1.00 | 21.21 | 1.69 | 16.00 | 20.00 | 22.00 | 22.00 | 26.00 |
| temp | 149 | 0.97 | 38.56 | 0.98 | 35.20 | 38.20 | 38.80 | 39.20 | 40.80 |
| bmi | 0 | 1.00 | 46.89 | 55.39 | -1200.00 | 24.56 | 32.12 | 50.01 | 1250.00 |
| days_onset_hosp | 256 | 0.96 | 2.06 | 2.26 | 0.00 | 1.00 | 1.00 | 3.00 | 22.00 |
データセット全体の情報を得るために、ベース R にある summary() を使用することもできますが、この出力は skimr を使用した場合よりも読みづらくなる可能性があります。そのため、ページスペースを倹約するため下記の結果は表示していません。
## データセットの各列の情報を取得
summary(linelist)
要約統計量
ベース R を使い、数値列の要約統計量を得ることができます。以下のように summary() を使用すると、数値列の有用な要約統計量の殆どを得ることができます。データフレーム名を以下のように指定しなければならないことにも注意してください。
summary(linelist$age_years) Min. 1st Qu. Median Mean 3rd Qu. Max. NAs
0.00 6.00 13.00 16.02 23.00 84.00 86 インデックスブラケット [ ]で特定の一部分にアクセスして保存することができます。:
summary(linelist$age_years)[[2]] # 2番目の要素のみを取得[1] 6# 同様に、要素名による指定も可能
# summary(linelist$age_years)[["1st Qu."]] max()、 min()、 median()、mean()、 quantile()、 sd()、および range() などの ベース の関数を使って、個々の統計量を得ることができます。統計量の全リストは R の基礎 章を参照してください。.
注意: R ではデータに欠測値が含まれている場合、そのことを知らせるために NA を表示します。欠測値を無視したい場合は、統計量の関数を指定する際に引数 na.rm = TRUE を指定します。.
rstatix パッケージの get_summary_stats() を使用すると データフレーム形式 で要約統計量を取得できます。これは、それ以降の演算を行ったり、数値をプロットするのに役立ちます。rstatix パッケージとその関数の詳細については、 簡単な統計的検定 章を参照してください。
linelist %>%
  get_summary_stats(
    age, wt_kg, ht_cm, ct_blood, temp,  # 計算をする行
    type = "common")                    # 利用する要約統計量を指定
# A tibble: 5 × 10
variable n min max median iqr mean sd se ci
<fct> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 age 5802 0 84 13 17 16.1 12.6 0.166 0.325
2 wt_kg 5888 -11 111 54 25 52.6 18.6 0.242 0.475
3 ht_cm 5888 4 295 129 68 125. 49.5 0.645 1.26
4 ct_blood 5888 16 26 22 2 21.2 1.69 0.022 0.043
5 temp 5739 35.2 40.8 38.8 1 38.6 0.977 0.013 0.02517.3 janitor パッケージ
janitor パッケージには集計表やクロス集計表を作成するために tabyl() があり、ヘルパー関数を利用して「加工」したり、変更したりすることでパーセンテージ、割合、カウント数などを表示などを行えます。
以下では linelist データフレームを janitor パッケージの関数にパイプ演算子で渡し、結果を表示しています。必要に応じて、代入演算子 <-を使って結果のテーブルを保存することもできます。
tabyl のシンプルな使い方
デフォルトでは、特定の列に対して tabyl() を使用すると、ユニークな値、カウント数、および列ごとの「パーセンテージ」(実際には割合)が生成されます。割合は桁数が多く表示されるかもしれません。後述する adorn_rounding() を使うことで小数部分の桁数を調整できます。
linelist %>% tabyl(age_cat) age_cat n percent valid_percent
0-4 1095 0.185971467 0.188728025
5-9 1095 0.185971467 0.188728025
10-14 941 0.159816576 0.162185453
15-19 743 0.126188859 0.128059290
20-29 1073 0.182235054 0.184936229
30-49 754 0.128057065 0.129955188
50-69 95 0.016134511 0.016373664
70+ 6 0.001019022 0.001034126
<NA> 86 0.014605978 NA上図のように、欠測値がある場合は行に <NA>と記載されて表示されます。show_na = FALSEと指定すると、表示されなくなります。 欠測値がない場合は、この行が表示されることはありません。欠測値がある場合、割合は、すべての列(分母に NA 数を含む)と「実際の数」(分母に NA 数を含まない)に対しての両方で表示されます。
列が因子型で、データに特定のレベルしか存在しない場合でも、すべてのレベルが表に表示されます。この機能をオフにするには、 show_missing_levels = FALSE と指定します。詳細は 因子(ファクタ)型データ 章を参照してください。
クロス集計表
クロス集計表のカウント数は tabyl() 内で 1 つ以上の列を追加することで実現できます現在はカウント数のみが表示されていますが、割合やパーセントは以下の手順で追加できます。
linelist %>% tabyl(age_cat, gender) age_cat f m NA_
0-4 640 416 39
5-9 641 412 42
10-14 518 383 40
15-19 359 364 20
20-29 468 575 30
30-49 179 557 18
50-69 2 91 2
70+ 0 5 1
<NA> 0 0 86tabyl を 「加工する」
janitor パッケージの adorn_*() 関数を使用して、合計値を加算したり、割合やパーセントに変換したり、その他の方法で表示を調整します。多くの場合、これらの関数のいくつかに tabyl をパイプ演算子で渡します。
| 関数 | 説明 |
|---|---|
adorn_totals() |
合計値を追加 (where = “row”、“col”、または “both”)。name = を “Total” と指定。 |
adorn_percentages() |
denominator =を “row”、“col”、または “all” と指定してカウント数を割合に変換する。 |
adorn_pct_formatting() |
割合をパーセントに変換。 digits =で小数点桁数を指定する。“%” 記号を削除する場合は affix_sign = FALSEと指定する。 |
adorn_rounding() |
割合を丸めるには、 digits = で小数点桁数を指定する。パーセントを丸めるにはadorn_pct_formatting() を用い、digits =で小数点桁数を指定する。 |
adorn_ns() |
割合あるいはパーセントの表にカウント数を追加する。パーセントの後にカウント数を括弧内に表示する場合は position = “rear” (後ろの意味)、カウント数の後にパーセントを括弧内に表示する場合はposition = “front”(前の意味)とそれぞれ位置を指定する。 |
adorn_title() |
引数 row_name = および/または col_name =で文字列を追加する。 |
上記の関数を利用する場合には、その順序を意識してください。以下に例を示します。
デフォルトの割合の代わりにパーセントを使用したシンプルな一元表(one-way table)です。
linelist %>%               # 症例ラインリスト
  tabyl(age_cat) %>%       # 年齢カテゴリごとにカウント数と割合の表を作成
  adorn_pct_formatting()   # 割合をパーセントに変換
age_cat n percent valid_percent
0-4 1095 18.6% 18.9%
5-9 1095 18.6% 18.9%
10-14 941 16.0% 16.2%
15-19 743 12.6% 12.8%
20-29 1073 18.2% 18.5%
30-49 754 12.8% 13.0%
50-69 95 1.6% 1.6%
70+ 6 0.1% 0.1%
<NA> 86 1.5% -行合計と行パーセントのクロス集計表です。
linelist %>%
  tabyl(age_cat, gender) %>%                  # 年齢と性別のカウント数
  adorn_totals(where = "row") %>%             # 行合計を追加
  adorn_percentages(denominator = "row") %>%  # カウント数を割合に変換
  adorn_pct_formatting(digits = 1)            # 割合をパーセントに変換
age_cat f m NA_
0-4 58.4% 38.0% 3.6%
5-9 58.5% 37.6% 3.8%
10-14 55.0% 40.7% 4.3%
15-19 48.3% 49.0% 2.7%
20-29 43.6% 53.6% 2.8%
30-49 23.7% 73.9% 2.4%
50-69 2.1% 95.8% 2.1%
70+ 0.0% 83.3% 16.7%
<NA> 0.0% 0.0% 100.0%
Total 47.7% 47.6% 4.7%カウント数とパーセントの両方が表示されるように調整したクロス集計表です。
linelist %>%                                  # 症例ラインリスト
  tabyl(age_cat, gender) %>%                  # カウント数についてのクロス集計
  adorn_totals(where = "row") %>%             # 行合計を追加
  adorn_percentages(denominator = "col") %>%  # 割合に変換
  adorn_pct_formatting() %>%                  # パーセントに変換
  adorn_ns(position = "front") %>%            # "count (percent)"となるように表示を変更
  adorn_title(                                # タイトルを調整
    row_name = "Age Category",
    col_name = "Gender")
Gender
Age Category f m NA_
0-4 640 (22.8%) 416 (14.8%) 39 (14.0%)
5-9 641 (22.8%) 412 (14.7%) 42 (15.1%)
10-14 518 (18.5%) 383 (13.7%) 40 (14.4%)
15-19 359 (12.8%) 364 (13.0%) 20 (7.2%)
20-29 468 (16.7%) 575 (20.5%) 30 (10.8%)
30-49 179 (6.4%) 557 (19.9%) 18 (6.5%)
50-69 2 (0.1%) 91 (3.2%) 2 (0.7%)
70+ 0 (0.0%) 5 (0.2%) 1 (0.4%)
<NA> 0 (0.0%) 0 (0.0%) 86 (30.9%)
Total 2,807 (100.0%) 2,803 (100.0%) 278 (100.0%)tabyl の出力
デフォルトでは、tabyl は R のコンソールに生データを出力します。
ほかに、tabyl を flextable などのパッケージに渡して、RStudio ビューアで「きれいな」画像として出力し、.png、.jpeg、.html などの形式でエクスポートすることもできます。 これについては 見やすい表の作り方 章で説明しています。この方法で出力して adorn_titles() を使用する場合は、 placement = "combined" を指定する必要があることに注意してください。
linelist %>%
  tabyl(age_cat, gender) %>%
  adorn_totals(where = "col") %>%
  adorn_percentages(denominator = "col") %>%
  adorn_pct_formatting() %>%
  adorn_ns(position = "front") %>%
  adorn_title(
    row_name = "Age Category",
    col_name = "Gender",
    placement = "combined") %>% # 画像として出力するためにこれは必要
  flextable::flextable() %>%    # きれいな画像に変換
  flextable::autofit()          # 1行ごとにフォーマット
Age Category/Gender |
f |
m |
NA_ |
Total |
|---|---|---|---|---|
0-4 |
640 (22.8%) |
416 (14.8%) |
39 (14.0%) |
1,095 (18.6%) |
5-9 |
641 (22.8%) |
412 (14.7%) |
42 (15.1%) |
1,095 (18.6%) |
10-14 |
518 (18.5%) |
383 (13.7%) |
40 (14.4%) |
941 (16.0%) |
15-19 |
359 (12.8%) |
364 (13.0%) |
20 (7.2%) |
743 (12.6%) |
20-29 |
468 (16.7%) |
575 (20.5%) |
30 (10.8%) |
1,073 (18.2%) |
30-49 |
179 (6.4%) |
557 (19.9%) |
18 (6.5%) |
754 (12.8%) |
50-69 |
2 (0.1%) |
91 (3.2%) |
2 (0.7%) |
95 (1.6%) |
70+ |
0 (0.0%) |
5 (0.2%) |
1 (0.4%) |
6 (0.1%) |
0 (0.0%) |
0 (0.0%) |
86 (30.9%) |
86 (1.5%) |
他の表での使用
janitor パッケージの adorn_*() は、 dplyr パッケージの summarise() や count()、 base R の table() で作成した表など、他の表でも使用できます。必要な janitor パッケージの関数を表をパイプ関数に渡すだけです。例えば、以下のようになります。
linelist %>%
  count(hospital) %>%   # dplyrパッケージの関数
  adorn_totals()        # janitorパッケージの関数
hospital n
Central Hospital 454
Military Hospital 896
Missing 1469
Other 885
Port Hospital 1762
St. Mark's Maternity Hospital (SMMH) 422
Total 5888tabyl の保存
flextableのようなパッケージを使って表を「きれいな」画像に変換すると、そのパッケージの関数、例えば save_as_html(), save_as_word(), save_as_ppt(), およびsave_as_image() を使って表を保存できます (詳しくは 見やすい表の作り方 の章で説明します)。以下では、表を Word 文書として保存し、さらに手作業で編集できるようにします。
linelist %>%
  tabyl(age_cat, gender) %>%
  adorn_totals(where = "col") %>%
  adorn_percentages(denominator = "col") %>%
  adorn_pct_formatting() %>%
  adorn_ns(position = "front") %>%
  adorn_title(
    row_name = "Age Category",
    col_name = "Gender",
    placement = "combined") %>%
  flextable::flextable() %>%                     # 画像に変換
  flextable::autofit() %>%                       # 1行のみであることを確認
  flextable::save_as_docx(path = "tabyl.docx")   # ファイルパスでWordドキュメントとして保存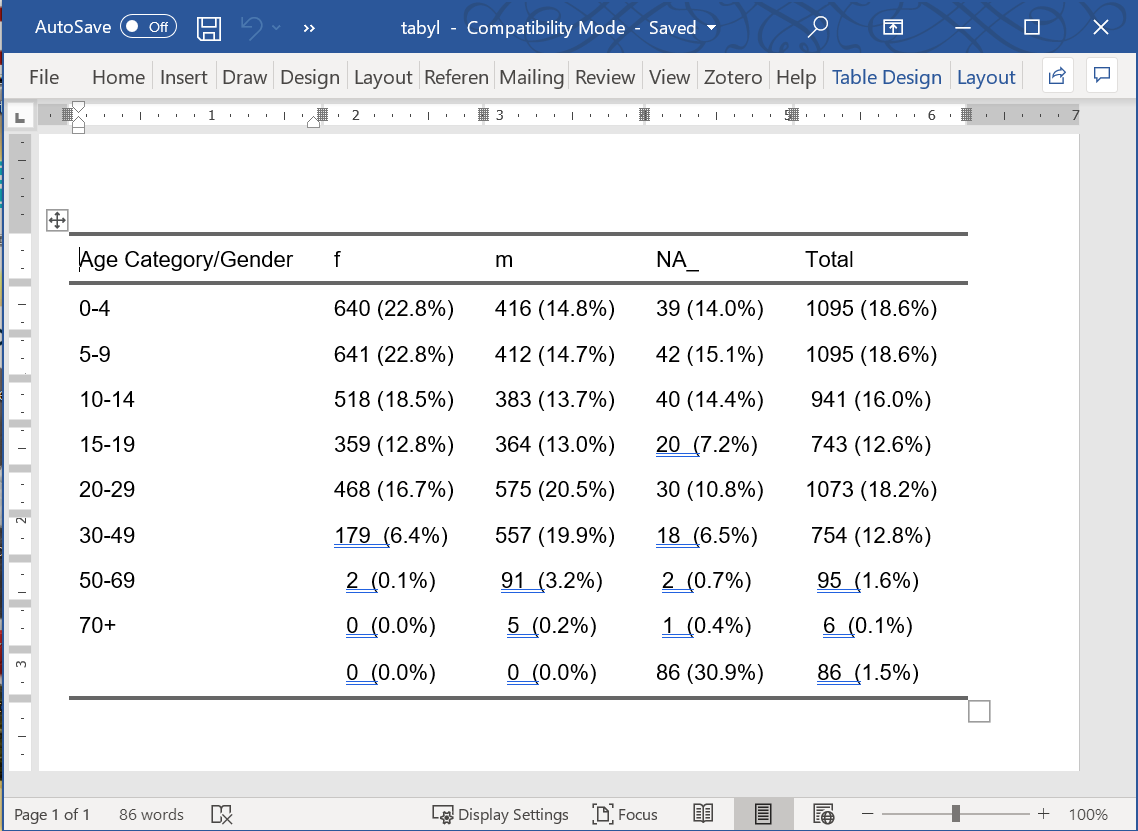
統計量
statsパッケージの chisq.test() や fisher.test() のように、以下のように tabyls に統計的検定を用いることができます。欠測値は許容されないため、show_na = FALSE で tabyl から除外されることに注意してください。
70+ の行には期待度数が 5 未満のセルがあり、カイ二乗近似は信頼できないため、ここでは fisher.test() を使います。この 8 x 2 の表では正確な p 値の計算に必要なメモリが大きすぎるため、simulate.p.value = TRUE で p 値を推定し、set.seed() で結果を再現可能にします。
age_by_outcome <- linelist %>%
  tabyl(age_cat, outcome, show_na = FALSE)

set.seed(1)
fisher.test(age_by_outcome, simulate.p.value = TRUE)
    Fisher's Exact Test for Count Data with simulated p-value (based on
    2000 replicates)

data:  age_by_outcome
p-value = 0.4863
alternative hypothesis: two.sided
統計に関する詳しいコードやヒントは 簡単な統計的検定 の章をご覧ください。
その他のヒント
- 上記の計算から欠測値を除外するには、引数
na.rm = TRUEを指定します。 -
tabyl()で作成されていない表にadorn_*()ヘルパー関数を用いる場合、adorn_percentage(,,,c(cases,deaths))のように、特定の列を指定することができます(4 番目の指定していなかった引数にそれらを指定します)。この構文は単純ではありません。代わりにsummarise()の使用を検討してください。 - 詳しくは janitor ページ and this tabyl ヴィネットをご一読ください.
17.4 dplyr パッケージ
dplyr パッケージは、 tidyverse パッケージの一部であり、とても一般的なデータ管理ツールです。summarise() や count() といった dplyr パッケージの関数による表作成は、要約統計量の計算、グループ ごとの要約、 または ggplot() への表出力をする際に便利な方法です。
summarise() は、新しい要約データフレーム を作成します。データが グループ化されていない 場合は、データフレーム全体に対して指定された要約統計量を 1 行のデータフレームとして作成します。データがグループ化されている場合は、新しいデータフレームはグループごとに 1 行が作成されます( データのグループ化 の章を参照)。
summarise() の括弧の中に、それぞれの新しい要約列の名前、等号、適用する統計関数を記入します。
ヒント: summarise 関数は、UK と US の両方のスペルで動作します(summarise() および summarize())。
カウント数の取得
summarise() 内で適用する最もシンプルな関数は n() です。括弧を空にすると、行数がカウントされます。
linelist %>%                 # linelistで開始
  summarise(n_rows = n())    # n_rows列の新しい要約データフレームを取得
n_rows
1 5888あらかじめデータをグループ化しておくと、さらに面白いことができます。
linelist %>%
  group_by(age_cat) %>%     # age_cat列のユニークな値でデータをグループ化
  summarise(n_rows = n())   # *グループごと* に行数を返す
# A tibble: 9 × 2
age_cat n_rows
<fct> <int>
1 0-4 1095
2 5-9 1095
3 10-14 941
4 15-19 743
5 20-29 1073
6 30-49 754
7 50-69 95
8 70+ 6
9 <NA> 86上記のコマンドは、代わりに count() を使うと短縮できます。count() は次のような処理を行います。:
- 与えられた列によってデータをグループ化する
- それらを
n()でまとめる(n列を作る) - データのグループ化解除
linelist %>%
  count(age_cat)
age_cat n
1 0-4 1095
2 5-9 1095
3 10-14 941
4 15-19 743
5 20-29 1073
6 30-49 754
7 50-69 95
8 70+ 6
9 <NA> 86name =に指定すると、カウントする列の名前をデフォルトの n から別の名前に変更できます。
2 つ以上のグループ化された列のカウント数を集計する場合も、カウント数を n 列に入れた「縦」形式で返されます。「縦」および「横」データ形式については、 データの縦横変換 の章を参照してください。
linelist %>%
  count(age_cat, outcome)
age_cat outcome n
1 0-4 Death 471
2 0-4 Recover 364
3 0-4 <NA> 260
4 5-9 Death 476
5 5-9 Recover 391
6 5-9 <NA> 228
7 10-14 Death 438
8 10-14 Recover 303
9 10-14 <NA> 200
10 15-19 Death 323
11 15-19 Recover 251
12 15-19 <NA> 169
13 20-29 Death 477
14 20-29 Recover 367
15 20-29 <NA> 229
16 30-49 Death 329
17 30-49 Recover 238
18 30-49 <NA> 187
19 50-69 Death 33
20 50-69 Recover 38
21 50-69 <NA> 24
22 70+ Death 3
23 70+ Recover 3
24 <NA> Death 32
25 <NA> Recover 28
26 <NA> <NA> 26すべてのレベルを表示
因子 型の列を表にする場合、 summarise() または count() コマンドに .drop = FALSE を追加して指定することで、データ内の値を持つレベルだけでなく、すべて のレベルが表示されるようにすることができます。
この手法は、表やグラフを標準化するのに有効です。例えば、複数のサブグループのために数値を作成している場合や、ルーチンレポートのために数値を繰り返し作成している場合などです。これらの状況のいずれにおいても、データ内の値の存在は変動する可能性がありますが、一定に保たれるレベルを定義できます。
詳しくは 因子(ファクタ)型データ の章をご覧ください。
割合
割合を追加するには、表を mutate() にパイプ演算子に渡して新しい列を作成します。新しい列は、カウントする列(デフォルトではn )をカウントする列の sum() で割ったものとして定義します(割合が計算されます)。
この場合、 mutate() 中のsum() コマンドは、割合の分母として使用しているために、列全体の n を合計していることに注意してください。データのグループ化 の章で説明したように、**もし* グループ化された データの中で sum() が使われた場合(例えば mutate() の直後に group_by() コマンドが使われた場合)は、グループごとの合計が得られます。先に述べたように、 count() は グループ化を解除する と結果は変わります。つまり、その場合は、すべての列に対する割合が計算されます。
パーセント(%)を表示させるには、scales パッケージの percent() で割合を囲むことで簡単に行えます(文字列型へ変換することに注意してください)。
age_summary <- linelist %>%
  count(age_cat) %>%                     # 性別によるグループ化とカウント("n"列を生成)
  mutate(                                # 列のパーセントの作成 - 分母に注意
    percent = scales::percent(n / sum(n)))

# 出力
age_summary
age_cat n percent
1 0-4 1095 18.60%
2 5-9 1095 18.60%
3 10-14 941 15.98%
4 15-19 743 12.62%
5 20-29 1073 18.22%
6 30-49 754 12.81%
7 50-69 95 1.61%
8 70+ 6 0.10%
9 <NA> 86 1.46%以下は、グループ内の割合を計算する方法です。異なるレベルのデータのグループ化を適用したり削除したりを順番に行っていきます。まず、データは group_by() で outcome を指定することでグループ化されます。次に、count() を適用します。この関数は、データをage_cat でさらにグループ化し、各結果と outcome-age-cat の組み合わせのカウント数を取得します。重要なことは、count() は処理を終えると同時に、age_cat によるグループ化を解除するので、残ったデータのグループ化は元の結果によるグループ化のみになるということです。つまり、割合を計算する最後のステップ(分母 sum(n))では outcomeによってグループ化されたままということになります。
age_by_outcome <- linelist %>%                  # linelistから開始
  group_by(outcome) %>%                         # 転帰でグループ化
  count(age_cat) %>%                            # age_catでグループ化してカウント後、age_catのグループ化を解除
  mutate(percent = scales::percent(n / sum(n))) # パーセントの算出 - 分母が結果グループごとであることに注意
プロット
上記のような「縦」の表出力を ggplot() で表示するのは、比較的簡単です。データは当然 「縦」持ち形式であり、ggplot() はそれを受け入れることができます。ggplot の基礎 と ggplot のヒント の章でさらに例をご覧ください。
linelist %>%                      # linelistから開始
  count(age_cat, outcome) %>%     # グループ化して2列で集計
  ggplot()+                       # ggplotに新しいデータフレームを渡す
    geom_col(                     # 棒グラフの作成
      mapping = aes(
        x = outcome,              # X軸にoutcomeをマッピング
        fill = age_cat,           # fill に age_catをマッピング(age_catで色分け)
        y = n))                   # カウント列"n"を高さにマッピング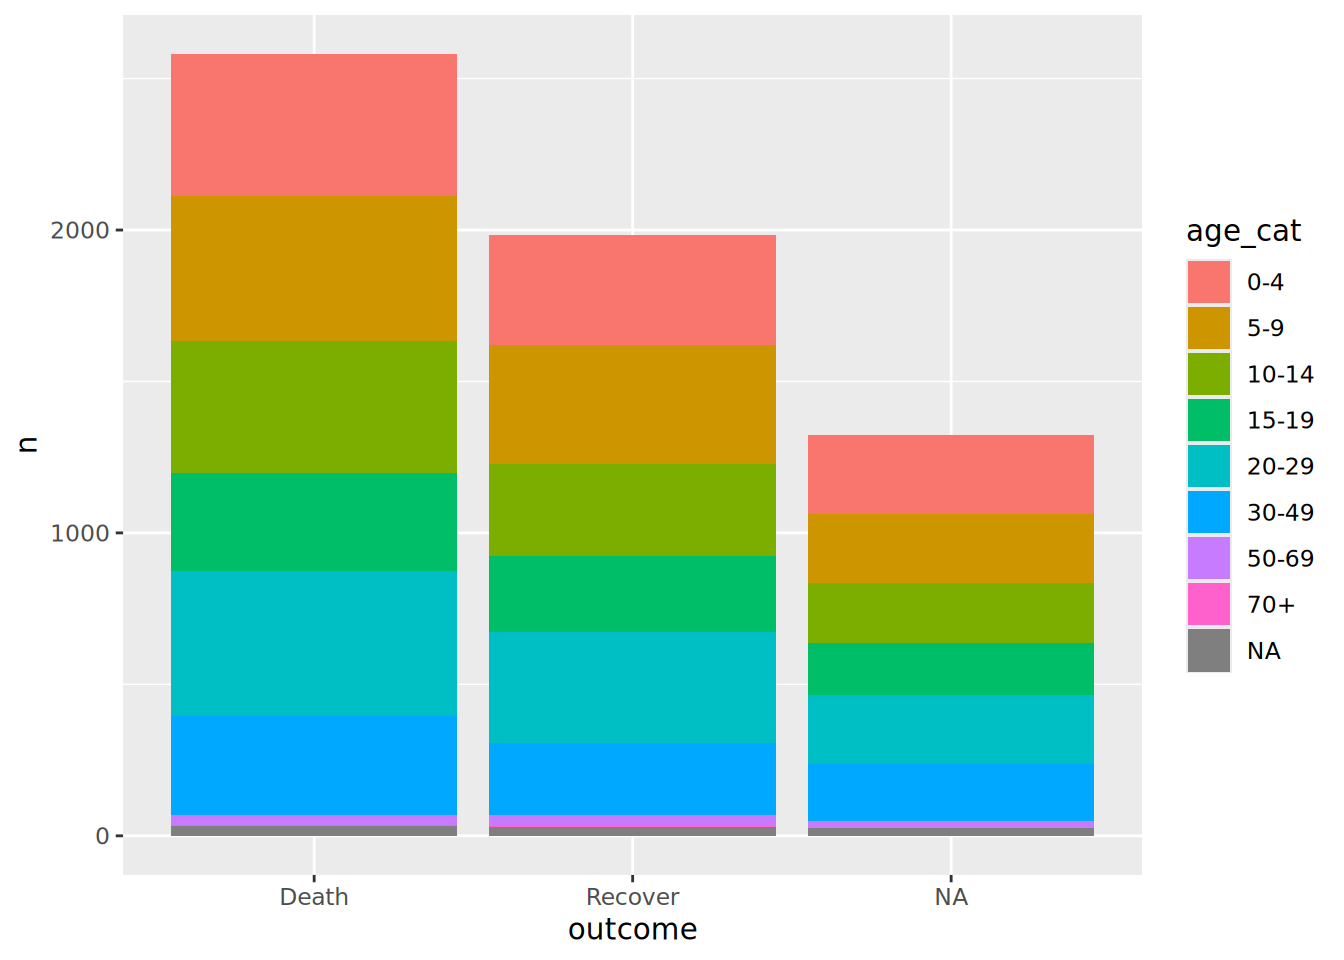
要約統計量
dplyr パッケージの summarise() の大きな利点は、 median()、mean()、max()、min()、sd()(標準偏差)、パーセンタイルなどのより高度な要約統計量を取得できることです。また、 sum() を使って、特定の論理的条件を満たす行の数を取得することもできます。上記のように、データフレームセット全体、またはグループごとにこうした出力を行うことができます。
構文は同じで、 summarise() の括弧の中に、新しい各要約列の名前、等号、適用する統計関数を指定します。統計関数の中では、操作する列と関連する引数を指定します(例:殆ど数学関数では na.rm = TRUE )。
また、sum() を使って、論理的な基準を満たす行の数を取得することができます。() 内の式が TRUE と評価された場合にカウントされます。例えば、以下のようになります:
-
sum(age_years < 18, na.rm=T)
-
sum(gender == "male", na.rm=T)
sum(response %in% c("Likely", "Very Likely"))
以下では、linelist データを症状発現から入院までの遅延日数( days_onset_hosp 列)を病院別にまとめています。
summary_table <- linelist %>%                                        # linelist から開始し、新規オブジェクトとして保存
  group_by(hospital) %>%                                             # すべての計算を病院ごとにまとめる
  summarise(                                                         # 以下の列の要約を取得
    cases       = n(),                                                # グループごとの行数
    delay_max   = max(days_onset_hosp, na.rm = T),                    # 最大の遅延日数
    delay_mean  = round(mean(days_onset_hosp, na.rm=T), digits = 1),  # 平均の遅延日数(丸める)
    delay_sd    = round(sd(days_onset_hosp, na.rm = T), digits = 1),  # 遅延日数の標準偏差(丸める)
    delay_3     = sum(days_onset_hosp >= 3, na.rm = T),               # 3日以上の遅延日数の行数
    pct_delay_3 = scales::percent(delay_3 / cases)                    # 3日以上の遅延日数の行数列をパーセントに変換
  )

summary_table  # 出力
# A tibble: 6 × 7
hospital cases delay_max delay_mean delay_sd delay_3 pct_delay_3
<chr> <int> <dbl> <dbl> <dbl> <int> <chr>
1 Central Hospital 454 12 1.9 1.9 108 24%
2 Military Hospital 896 15 2.1 2.4 253 28%
3 Missing 1469 22 2.1 2.3 399 27%
4 Other 885 18 2 2.2 234 26%
5 Port Hospital 1762 16 2.1 2.2 470 27%
6 St. Mark's Maternity … 422 18 2.1 2.3 116 27% ヒント:
-
sum()をロジカル型と共に利用することで、特定の条件 (==)を満たす行を「数える」ことができます。 -
sum()のような数学関数では、na.rm = TRUEを使用することに注意してください。そうしない場合、欠測値がある場合にNAが返されます。 -
scales パッケージの関数
percent()を使って、簡単にパーセントに変換することができます。- 小数点以下1桁を表示するには
accuracy =0.1、また 2桁を表示するにはaccuracy =0.01と、それぞれ指定します。
- 小数点以下1桁を表示するには
-
base R の
round()を使用して小数点以下を指定します。 - これらの統計量をデータセット全体で計算するには、
group_by()を使用せずにsummarise()を使用します。 - 後で計算するための列(分母など)を作成し、最終的に
select()でデータフレームから削除することもできます。
条件付き統計量
特定の条件を満たす行の最大値など、条件付き統計量 を取得したい場合がありますこれは、括弧 [ ]で列をサブセットすることで実現できます。以下 の例では、発熱があると分類された患者と発熱がないと分類された患者の最高体温を取得します。ただし、(下記に示すように) group_by() コマンドや pivot_wider() に別の列を追加する方が適切な場合もあるので注意してください。
linelist %>%
  group_by(hospital) %>%
  summarise(
    max_temp_fvr = max(temp[fever == "yes"], na.rm = T),
    max_temp_no = max(temp[fever == "no"], na.rm = T)
  )
# A tibble: 6 × 3
hospital max_temp_fvr max_temp_no
<chr> <dbl> <dbl>
1 Central Hospital 40.4 38
2 Military Hospital 40.5 38
3 Missing 40.6 38
4 Other 40.8 37.9
5 Port Hospital 40.6 38
6 St. Mark's Maternity Hospital (SMMH) 40.6 37.9のりづけ (Glueing)
stringr の関数 str_glue() は、複数の列の値を 1 つの新しい列にまとめるのに便利です。この文脈では、一般的に summarise() コマンドの 後 に使用します。
文字型・文字列型データ の章では、 unite() や paste0() など、列を結合するためのさまざまなオプションについて説明しています。この使用例では、 unite() よりも柔軟性があり、paste0() よりもシンプルな構文である str_glue() を提唱します。
以下では、上で作成した summary_table データフレームを delay_mean 列とdelay_sd 列が組み合わされるように変更し、新しい列に括弧の整形を追加し、それぞれの古い列を削除しています。
そして、表の見栄えをよりよくするために、 janitor パッケージの adorn_totals() を使って合計行を追加します(これは数字以外の列を無視します)。最後に、 dplyr パッケージの select() を使用して、列の並び替え、より適切な列名に名前を変更します。
これで、 flextable パッケージに渡して、表を word、.png、.jpeg、.html、Powerpoint、RMarkdown などに印刷することができるようになりました!( 見やすい表の作り方 の章を参照)。
summary_table %>%
  mutate(delay = str_glue("{delay_mean} ({delay_sd})")) %>%  # 他の値を組み合わせてフォーマット
  select(-c(delay_mean, delay_sd)) %>%                       # 古い2列を削除
  adorn_totals(where = "row") %>%                            # 合計列を追加
  select(                                                    # 列の順番と名称を指定
    "Hospital Name"   = hospital,
    "Cases"           = cases,
    "Max delay"       = delay_max,
    "Mean (sd)"       = delay,
    "Delay 3+ days"   = delay_3,
    "% delay 3+ days" = pct_delay_3
    )
Hospital Name Cases Max delay Mean (sd) Delay 3+ days
Central Hospital 454 12 1.9 (1.9) 108
Military Hospital 896 15 2.1 (2.4) 253
Missing 1469 22 2.1 (2.3) 399
Other 885 18 2 (2.2) 234
Port Hospital 1762 16 2.1 (2.2) 470
St. Mark's Maternity Hospital (SMMH) 422 18 2.1 (2.3) 116
Total 5888 101 - 1580
% delay 3+ days
24%
28%
27%
26%
27%
27%
-パーセンタイル
dplyr パッケージの パーセンタイルと分位数は特筆に値します。分布を取得するには、デフォルトで quantile() を使用するか、 probs =で必要な値を指定します。
# 年齢のデフォルトパーセンタイル値の取得 (0%, 25%, 50%, 75%, 100%)
linelist %>%
  reframe(age_percentiles = quantile(age_years, na.rm = TRUE))
age_percentiles
1 0
2 6
3 13
4 23
5 84# 手動で指定した年齢のパーセンタイル値を取得 (5%, 50%, 75%, 98%)
linelist %>%
reframe(
age_percentiles = quantile(
age_years,
probs = c(.05, 0.5, 0.75, 0.98),
na.rm=TRUE)
) age_percentiles
1 1
2 13
3 23
4 48グループごとに数量を取得したい場合、 group_by() に単純に別の列を追加すると、長くてあまり役に立たない出力になる可能性があります。そこで、代わりに「必要な分位数レベルごとに列を作成する 方法を試してみてください。
# 手動で指定した年齢のパーセンタイル値を取得 (5%, 50%, 75%, 98%)
linelist %>%
  group_by(hospital) %>%
  summarise(
    p05 = quantile(age_years, probs = 0.05, na.rm=T),
    p50 = quantile(age_years, probs = 0.5, na.rm=T),
    p75 = quantile(age_years, probs = 0.75, na.rm=T),
    p98 = quantile(age_years, probs = 0.98, na.rm=T)
    )
# A tibble: 6 × 5
hospital p05 p50 p75 p98
<chr> <dbl> <dbl> <dbl> <dbl>
1 Central Hospital 1 12 21 48
2 Military Hospital 1 13 24 45
3 Missing 1 13 23 48.2
4 Other 1 13 23 50
5 Port Hospital 1 14 24 49
6 St. Mark's Maternity Hospital (SMMH) 2 12 22 50.2dplyr パッケージの summarise() は確かにより細かい制御が可能ですが、必要なすべての要約統計量は rstatix パッケージの get_summary_stat() で生成できることに気づくかもしれません。グループ化されたデータに適用した場合、 0%、25%、50%、75%、100% の値を取得します。グループ化されていないデータに適用する場合は、probs = c(.05, .5, .75, .98)でパーセンタイルを指定できます。
linelist %>%
  group_by(hospital) %>%
  rstatix::get_summary_stats(age, type = "quantile")
# A tibble: 6 × 8
hospital variable n `0%` `25%` `50%` `75%` `100%`
<chr> <fct> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Central Hospital age 445 0 6 12 21 58
2 Military Hospital age 884 0 6 14 24 72
3 Missing age 1441 0 6 13 23 76
4 Other age 873 0 6 13 23 69
5 Port Hospital age 1739 0 6 14 24 68
6 St. Mark's Maternity Hospital (… age 420 0 7 12 22 84linelist %>%
rstatix::get_summary_stats(age, type = "quantile")# A tibble: 1 × 7
variable n `0%` `25%` `50%` `75%` `100%`
<fct> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 age 5802 0 6 13 23 84集計されたデータをまとめる
集計されたデータから始めた場合、 n() を使用すると、集計されたカウントの合計ではなく、行 数を取得します。合計を取得するには、データのカウント列に対して sum() を使用します。
例えば、下記の件数データフレーム linelist_agg を使用しているとしましょう。 これは、結果と性別ごとのケース数を「縦」持ち形式で表示しています。
以下では、結果および性別ごとの linelist 症例数のデータフレームの例を作成しています(わかりやすくするために欠測値は削除しています)。
linelist_agg <- linelist %>%
  drop_na(gender, outcome) %>%
  count(outcome, gender)

linelist_agg
outcome gender n
1 Death f 1227
2 Death m 1228
3 Recover f 953
4 Recover m 950グループ別に( n列の)カウントを合計するには、 summarise() を使用しますが、新しい列をsum(n, na.rm=T)と設定します。合計処理に条件付きの要素を追加するには、カウント列にサブセットブラケット [ ] 構文を使用します。
linelist_agg %>%
  group_by(outcome) %>%
  summarise(
    total_cases  = sum(n, na.rm=T),
    male_cases   = sum(n[gender == "m"], na.rm=T),
    female_cases = sum(n[gender == "f"], na.rm=T))
# A tibble: 2 × 4
outcome total_cases male_cases female_cases
<chr> <int> <int> <int>
1 Death 2455 1228 1227
2 Recover 1903 950 953
across() 複数の列
複数列に渡ってsummarise() を使用するには across() を使用します。こうすることで同じ統計量を多くの列で計算したい場合に便利になります。summarise() の中にacross() を置き、以下のように指定します。:
-
.cols =列名のベクトルc()または “tidyselect” ヘルパー関数(下記参照) -
.fns =実行する関数(括弧なし) -list()内に複数を指定できます。
以下では、mean() を複数の数値列に適用しています。列のベクトルは .cols =に明示的に命名され、ひとつの関数 mean は .fns =に(括弧なしで)指定されます。関数の追加の引数(例:na.rm=TRUE)は .fns == の後にコンマで区切って指定されます。
across() を使用する際には、括弧やカンマの順序を正しく設定するのが難しい場合がありますacross() の中には、列、関数、そして関数に必要な追加の引数を含める必要があることを覚えておいてください。
linelist %>%
  group_by(outcome) %>%
  summarise(across(.cols = c(age_years, temp, wt_kg, ht_cm),  # 列
                   .fns = ~ mean(.x, na.rm=T)))                                  # その他の引数
# A tibble: 3 × 5
outcome age_years temp wt_kg ht_cm
<chr> <dbl> <dbl> <dbl> <dbl>
1 Death 15.9 38.6 52.6 125.
2 Recover 16.1 38.6 52.5 125.
3 <NA> 16.2 38.6 53.0 125.複数の関数を一度に実行できます。以下では、関数 mean と sd がlist() 内の .fns = に提供されています。新しい列名に付加される文字名(例:“mean” や “sd”)を指定することができます。
linelist %>%
  group_by(outcome) %>%
  summarise(across(.cols = c(age_years, temp, wt_kg, ht_cm), # 列
                   .fns = list("mean" = ~mean(.x, na.rm=T), "sd" = ~sd(.x, na.rm=T))))                                 # 追加の引数
# A tibble: 3 × 9
outcome age_years_mean age_years_sd temp_mean temp_sd wt_kg_mean wt_kg_sd
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Death 15.9 12.3 38.6 0.962 52.6 18.4
2 Recover 16.1 13.0 38.6 0.997 52.5 18.6
3 <NA> 16.2 12.8 38.6 0.976 53.0 18.9
# ℹ 2 more variables: ht_cm_mean <dbl>, ht_cm_sd <dbl>ここでは、列を選択するために .cols = に提供できるそれらの “tidyselect” ヘルパー関数です。:
-
everything()- 記載されていない他のすべての列 -
last_col()- 最後の列 -
where()- すべての列に関数を適用し、TRUE となるものを選択する -
starts_with()- 指定された接頭辞にマッチします。例:starts_with("date") -
ends_with()- 指定された接尾辞にマッチします。例:ends_with("_end") -
contains()- 文字列を含む列を指定します。例:contains("time") -
matches()- 正規表現 (regex) を適用します。 例:contains("[pt]al") -
num_range()- -
any_of()- 列に名前がある場合にマッチします。名前が存在しない可能性がある場合に便利です。例:any_of(date_onset, date_death, cardiac_arrest)
例えば、すべての数値列の平均値を返すには、 where() を使い、as.numeric() という関数を(括弧を付けずに)指定します。これらはすべて across() コマンドの中で行われます。
linelist %>%
  group_by(outcome) %>%
  summarise(across(
    .cols = where(is.numeric),  # データフレーム内のすべての数値行
    .fns = ~ mean(.x, na.rm=T)))
# A tibble: 3 × 12
outcome generation age age_years lon lat wt_kg ht_cm ct_blood temp
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Death 16.7 15.9 15.9 -13.2 8.47 52.6 125. 21.3 38.6
2 Recover 16.4 16.2 16.1 -13.2 8.47 52.5 125. 21.1 38.6
3 <NA> 16.5 16.3 16.2 -13.2 8.47 53.0 125. 21.2 38.6
# ℹ 2 more variables: bmi <dbl>, days_onset_hosp <dbl>横への変換
表を「横」持ち形式にしたい場合は、 tidyr の pivot_wider() を使って変換できます。rename() で列名を変更する必要があるでしょう。詳細については データの縦横変換 章を参照してください。
以下の例では 割合のセクションから「縦」持ち表 age_by_outcome から始めます。わかりやすいように、もう一度作成して出力しましょう。:
age_by_outcome <- linelist %>%                  # linelistから開始
  group_by(outcome) %>%                         # 転帰でグループ化
  count(age_cat) %>%                            # age_catでグループ化してカウント後、age_catのグループ化を解除
  mutate(percent = scales::percent(n / sum(n))) # パーセントを計算 - 分母が転帰グループ別であることに注意
より広い範囲をピボット(縦横変換)するために、既存の列 age_cat の 値 から新しい列を作成します (names_from = age_catと設定します)。また、新しいテーブルの値は既存の列 nから取得するように指定し、 values_from = nとします。ピボットコマンドで言及されていない列(outcome)は、左端にそのまま残ります。
age_by_outcome %>%
  select(-percent) %>%   # 簡潔にするためにカウントのみを保持
  pivot_wider(names_from = age_cat, values_from = n)
# A tibble: 3 × 10
# Groups: outcome [3]
outcome `0-4` `5-9` `10-14` `15-19` `20-29` `30-49` `50-69` `70+` `NA`
<chr> <int> <int> <int> <int> <int> <int> <int> <int> <int>
1 Death 471 476 438 323 477 329 33 3 32
2 Recover 364 391 303 251 367 238 38 3 28
3 <NA> 260 228 200 169 229 187 24 NA 26行を合計する
summarise() がグループ化されたデータを処理するとき、自動的に「合計」の統計値を生成するわけではありません。以下では、合計行を追加するための 2 つの方法を紹介します。:
janitor パッケージの adorn_totals()
合計できる数や割合、パーセントだけで構成されている表の場合は、前のセクションで説明したように、janitor パッケージの adorn_totals() を使って 合計 値を追加できます。この関数は数値列の合計しかできないことに注意してください。他の合計要約統計量を計算したい場合は、 dplyr パッケージを使った次の方法を参照してください。
以下では、 linelist を男女別に分類し、結果が判明している症例数、死亡者数、回復者数を記載した表にまとめています。この表を adorn_totals() にパイプ演算子で渡すと、各列の合計を反映した合計行が下部に追加されます。さらに adorn_*() でコードにあるように表示を調整しています。
linelist %>%
  group_by(gender) %>%
  summarise(
    known_outcome = sum(!is.na(outcome)),           # グループ内で結果の欠測がない行数
    n_death  = sum(outcome == "Death", na.rm=T),    # グループ内でoutocomeが"Death"の行数
    n_recover = sum(outcome == "Recover", na.rm=T), # グループ内でoutocomeが"Recovered"の行数
  ) %>%
  adorn_totals() %>%                                # 合計行を加工 (各数値列の合計)
  adorn_percentages("col") %>%                      # 列で割合を取得
  adorn_pct_formatting() %>%                        # 割合をパーセントに変換
  adorn_ns(position = "front")                      # %とカウントを表示(カウントを先に)
gender known_outcome n_death n_recover
f 2,180 (47.8%) 1,227 (47.5%) 953 (48.1%)
m 2,178 (47.7%) 1,228 (47.6%) 950 (47.9%)
<NA> 207 (4.5%) 127 (4.9%) 80 (4.0%)
Total 4,565 (100.0%) 2,582 (100.0%) 1,983 (100.0%)“total” のデータに対してsummarise() を行い、次に bind_rows() を行う
median() や mean() などの要約統計量を含む表の場合、上記の adorn_totals() の方法では 十分では ありません。代わりに、データセット全体の要約統計を得るには、別の summarise() コマンドで計算し、その結果を元のグループ化された要約表にバインドする必要があります。データの結合 の章で説明したように、 dplyr パッケージの bind_rows() を使って結合を行うことができます。以下はその例です。:
group_by() と summarise() を使って、次のように 病院ごと の結果の要約表を作ることができます。:
by_hospital <- linelist %>%
  filter(!is.na(outcome) & hospital != "Missing") %>%  # 転帰や病院が欠測している症例(case)を削除
  group_by(hospital, outcome) %>%                      # データをグループ化
  summarise(                                           # 関心のある指標の新しい要約列を作成
    N = n(),                                            # 病院-転帰グループごとの行数
    ct_value = median(ct_blood, na.rm=T))               # グループごとのCT値の中央値

by_hospital # テーブルを出力
# A tibble: 10 × 4
# Groups: hospital [5]
hospital outcome N ct_value
<chr> <chr> <int> <dbl>
1 Central Hospital Death 193 22
2 Central Hospital Recover 165 22
3 Military Hospital Death 399 21
4 Military Hospital Recover 309 22
5 Other Death 395 22
6 Other Recover 290 21
7 Port Hospital Death 785 22
8 Port Hospital Recover 579 21
9 St. Mark's Maternity Hospital (SMMH) Death 199 22
10 St. Mark's Maternity Hospital (SMMH) Recover 126 22合計を得るには、同じ summarise() コマンドを実行しますが、下記のように、データを hospital ではなく outcome でグループ化します。:
totals <- linelist %>%
      filter(!is.na(outcome) & hospital != "Missing") %>%
      group_by(outcome) %>%                            # 病院をなくして転帰のみでグループ化
      summarise(
        N = n(),                                       # 転帰ごとのみの統計量
        ct_value = median(ct_blood, na.rm=T))

totals # 表を出力
# A tibble: 2 × 3
outcome N ct_value
<chr> <int> <dbl>
1 Death 1971 22
2 Recover 1469 22この 2 つのデータフレームを結合することができます。 by_hospital は 4 列で、 totals は 3 列であることに注意してください。bind_rows() を使用すると、列は名前ごとに結合され、余分なスペースは NA と表示されます(例えば、新しい 2 つの totals 行の hospital 列の値)。行を結合した後、 replace_na() を使用してこれらの空欄を “Total” に変換します( データクリーニングと主要関数 章を参照)。
table_long <- bind_rows(by_hospital, totals) %>%
  mutate(hospital = replace_na(hospital, "Total"))
以下は、新しい表の下部に “Total” の行がある状態です。
「縦」持ち形式のこの表があなたの望むものかもしれません。 オプション として、この表を ピボット で 横 持ちにして読みやすくするができます。上記の 横変換セクションや、データの縦横変換 の章を参照してください。また、列を追加して、きれいに並べることもできます。このコードを以下に示します。
table_long %>%

  # 横変換とフォーマット
  ########################
  mutate(hospital = replace_na(hospital, "Total")) %>%
  pivot_wider(                                         # 縦から横へ変換
    values_from = c(ct_value, N),                       # ct_valueとN(カウント)列から新規の値
    names_from = outcome) %>%                           # 転帰を新しい列名に
  mutate(                                              # 新規列を追加
    N_Known = N_Death + N_Recover,                               # 既知の症例数数
    Pct_Death = scales::percent(N_Death / N_Known, 0.1),         # 死亡症例のパーセント(小数点1桁)
    Pct_Recover = scales::percent(N_Recover / N_Known, 0.1)) %>% # 回復症例のパーセント(小数点1桁)
  select(                                              # 列の並べ替え
    hospital, N_Known,                                   # 最初の列
    N_Recover, Pct_Recover, ct_value_Recover,            # 回復症例の列
    N_Death, Pct_Death, ct_value_Death)  %>%             # 死亡症例の列
  arrange(N_Known)                                  # 行を最小から最大まで並べる(合計行は最下部)
# A tibble: 6 × 8
# Groups: hospital [6]
hospital N_Known N_Recover Pct_Recover ct_value_Recover N_Death Pct_Death
<chr> <int> <int> <chr> <dbl> <int> <chr>
1 St. Mark's M… 325 126 38.8% 22 199 61.2%
2 Central Hosp… 358 165 46.1% 22 193 53.9%
3 Other 685 290 42.3% 21 395 57.7%
4 Military Hos… 708 309 43.6% 22 399 56.4%
5 Port Hospital 1364 579 42.4% 21 785 57.6%
6 Total 3440 1469 42.7% 22 1971 57.3%
# ℹ 1 more variable: ct_value_Death <dbl>そして、続いてこの表を画像としてきれいに出力することができます。以下は、 flextableでの出力例です。今説明した例を「きれいな」表に仕上げる方法については 見やすい表の作り方 の章で詳しく説明しています。
Hospital |
Total cases with known outcome |
Recovered |
Died |
||||
|---|---|---|---|---|---|---|---|
Total |
% of cases |
Median CT values |
Total |
% of cases |
Median CT values |
||
St. Mark's Maternity Hospital (SMMH) |
325 |
126 |
38.8% |
22 |
199 |
61.2% |
22 |
Central Hospital |
358 |
165 |
46.1% |
22 |
193 |
53.9% |
22 |
Other |
685 |
290 |
42.3% |
21 |
395 |
57.7% |
22 |
Military Hospital |
708 |
309 |
43.6% |
22 |
399 |
56.4% |
21 |
Missing |
1,125 |
514 |
45.7% |
21 |
611 |
54.3% |
21 |
Port Hospital |
1,364 |
579 |
42.4% |
21 |
785 |
57.6% |
22 |
Total |
3,440 |
1,469 |
42.7% |
22 |
1,971 |
57.3% |
22 |
17.5 gtsummary パッケージ
要約統計量をきれいな出版原稿レベルの図版として出力したい場合、gtsummary パッケージとそこに含まれる関数 tbl_summary() を使用できます。最初はコードが複雑に見えるかもしれませんが、とてもきれいな出力で、RStudio ビューアパネルに HTML イメージとして表示されます。 ここのビニエットをご一読ください。
また、統計的検定の結果 gtsummary テーブルに追加することもできます。この処理については、簡単な統計的検定 章の gtsummary セクションで説明しています。
tbl_summary() を紹介するにあたり、まず最も基本的な動作を示します。これだけでも、大きく美しい表が生成されます。次に、表をより適した形に調整、修正する方法の詳細を解説します。
要約表
tbl_summary() のデフォルトの動作は非常に素晴らしく、指定された列を受け取り、ひとつのコマンドで要約表を作成します。この関数は、列のデータ型に応じた統計値を表示します。数値列では中央値と四分位範囲(IQR)、カテゴリ列ではカウント(%)を表示します。欠測値は “Unknown” に変換されます。統計量を説明するための脚注が下部に追加され,合計 N が上部に表示されます。
linelist %>%
  select(age_years, gender, outcome, fever, temp, hospital) %>%  # 興味のある列のみを残す
tbl_summary() # デフォルト| Characteristic | N = 5,8881 |
|---|---|
| age_years | 13 (6, 23) |
| Unknown | 86 |
| gender | |
| f | 2,807 (50%) |
| m | 2,803 (50%) |
| Unknown | 278 |
| outcome | |
| Death | 2,582 (57%) |
| Recover | 1,983 (43%) |
| Unknown | 1,323 |
| fever | 4,549 (81%) |
| Unknown | 249 |
| temp | 38.80 (38.20, 39.20) |
| Unknown | 149 |
| hospital | |
| Central Hospital | 454 (7.7%) |
| Military Hospital | 896 (15%) |
| Missing | 1,469 (25%) |
| Other | 885 (15%) |
| Port Hospital | 1,762 (30%) |
| St. Mark's Maternity Hospital (SMMH) | 422 (7.2%) |
| 1 Median (Q1, Q3); n (%) | |
調整
それでは、この機能の仕組みと調整方法について説明します。主要な論点を以下に詳述します。:
by = 列で層別することで(例えば、結果で)、二元表を作成することができます。
statistic = 表示する統計量とその表示方法を方程式で指定します。方程式は、チルダ ~ で区切られた2つの部分からなります。右側は希望する統計表示を引用符で囲み、左側にその表示を適用する列を指定します。
- 式の右側は、 stringr の
str_glue()の構文( 文字型・文字列型データを参照)を使い、希望する表示文字列を引用符で囲み、統計量そのものを波括弧で囲みます “n”(カウント数)、“N”(分母)、“mean”、“median”、“sd”、“max”、“min”、 “p##” のようなパーセンタイル値、または “p” として全体に対するパーセントなどの統計量を含めることができます。詳細は?tbl_summaryを参照してください。 - 式の左辺では、列を名前で指定したり(
ageまたはc(age, gender)など)、all_continuous()、all_categorical()、contains()、starts_with()などのヘルパーを使用したりすることができます。
statistic = の方程式の簡単な例として、age_years 列の平均値のみを表示する場合は以下のようになります。:
linelist %>%
  select(age_years) %>%         # 興味のある列だけを残す
  tbl_summary(                  # 要約表を作成
statistic = age_years ~ "{mean}") # 平均年齢を出力| Characteristic | N = 5,8881 |
|---|---|
| age_years | 16 |
| Unknown | 86 |
| 1 Mean | |
もう少し複雑な式であれば、 "({min}, {max})"のように、最大値と最小値を括弧で囲み、カンマで区切ったものがあります。:
linelist %>%
  select(age_years) %>%                       # 興味のある列だけを残す
  tbl_summary(                                # 要約表を作成
statistic = age_years ~ "({min}, {max})") # 年齢の最小値と最大値を出力| Characteristic | N = 5,8881 |
|---|---|
| age_years | (0, 84) |
| Unknown | 86 |
| 1 (Min, Max) | |
また、別々の列や列の種類に応じて構文を変えることもできます。以下の複雑な例では、 statistc = に指定された値は、すべての連続列に対しては平均値と括弧内の標準偏差を表示し、すべてのカテゴリ列に対しては n、分母、パーセントを表示することを示す リスト となっています。
digits = 桁数や丸め方を調整します。オプションとして、連続した列のみを対象とするように指定することもできます(以下のように)。
label = 列名の表示方法を調整します。列名と必要なラベルをチルダで区切って入力してください。デフォルトではカ列名が表示されます。
missing_text = 欠測値の表示方法を調整します。デフォルトは “Unknown” です。
type = 統計量を何段階で表示するかを調整するために使用します。構文は statistic = と似ていますが、左に列、右に値を持つ方程式を指定します。よくある 2 つのシナリオを紹介します。:
-
type = all_categorical() ~ "categorical"強制的に二分法のカラム(例:feveryes/no)を使用して、“yes” の行だけではなく、すべてのレベルを表示します。 -
type = all_continuous() ~ "continuous2"後のセクションで示すように、変数ごとに複数行の統計量を可能にします。
以下の例では、これらの各引数を使用して元の要約表を修正しています。:
linelist %>%
  select(age_years, gender, outcome, fever, temp, hospital) %>% # 興味のある列だけを残す
  drop_na(outcome) %>%
  tbl_summary(
    by = outcome,                                               # 転帰ごとにテーブル全体を層別化
    statistic = list(all_continuous() ~ "{mean} ({sd})",        # 連続列に対して統計量を算出してフォーマット
                     all_categorical() ~ "{n} / {N} ({p}%)"),   # カテゴリ列に対して統計量を算出してフォーマット
    digits = all_continuous() ~ 1,                              # 連続列に対して丸めの指定
    type   = all_categorical() ~ "categorical",                 # 強制的に全カテゴリ水準を表示
    label  = list(                                              # 列名のラベルを表示
      age_years ~ "Age (years)",
      gender    ~ "Gender",
      temp      ~ "Temperature",
      hospital  ~ "Hospital"),
    missing_text = "Missing"                                    # 欠測値の表示方法
)| Characteristic |
Death N = 2,5821 |
Recover N = 1,9831 |
|---|---|---|
| Age (years) | 15.9 (12.3) | 16.1 (13.0) |
| Missing | 32 | 28 |
| Gender | ||
| f | 1,227 / 2,455 (50%) | 953 / 1,903 (50%) |
| m | 1,228 / 2,455 (50%) | 950 / 1,903 (50%) |
| Missing | 127 | 80 |
| fever | ||
| no | 458 / 2,460 (19%) | 361 / 1,904 (19%) |
| yes | 2,002 / 2,460 (81%) | 1,543 / 1,904 (81%) |
| Missing | 122 | 79 |
| Temperature | 38.6 (1.0) | 38.6 (1.0) |
| Missing | 60 | 55 |
| Hospital | ||
| Central Hospital | 193 / 2,582 (7.5%) | 165 / 1,983 (8.3%) |
| Military Hospital | 399 / 2,582 (15%) | 309 / 1,983 (16%) |
| Missing | 611 / 2,582 (24%) | 514 / 1,983 (26%) |
| Other | 395 / 2,582 (15%) | 290 / 1,983 (15%) |
| Port Hospital | 785 / 2,582 (30%) | 579 / 1,983 (29%) |
| St. Mark's Maternity Hospital (SMMH) | 199 / 2,582 (7.7%) | 126 / 1,983 (6.4%) |
| 1 Mean (SD); n / N (%) | ||
連続変数の統計量を複数行表示
連続変数の統計量を複数行で表示したい場合は、type = を “continuous2” に設定することで可能です。どの統計量を表示するかを選択することで、先に示したすべての要素を 1 つの表にまとめることができます。 これを行うには、タイプを “continuous2” と入力して、表を返してほしいことを関数に伝える必要があります。欠測値の数は “Unknown” と表示されます。
linelist %>%
  select(age_years, temp) %>%                      # 興味のある列のみを残す
  tbl_summary(                                     # 要約表を作成する
    type = all_continuous() ~ "continuous2",       # 複数の統計量を出力したいことを指示
    statistic = all_continuous() ~ c(
      "{mean} ({sd})",                             # 行1には平均値とSD
      "{median} ({p25}, {p75})",                   # 行2には中央値とIQR
      "{min}, {max}")                              # 行3には最小値と最大値
)| Characteristic | N = 5,888 |
|---|---|
| age_years | |
| Mean (SD) | 16 (13) |
| Median (Q1, Q3) | 13 (6, 23) |
| Min, Max | 0, 84 |
| Unknown | 86 |
| temp | |
| Mean (SD) | 38.56 (0.98) |
| Median (Q1, Q3) | 38.80 (38.20, 39.20) |
| Min, Max | 35.20, 40.80 |
| Unknown | 149 |
p 値の追加、色や見出しの調整など、これらの表を修正する方法は他にもたくさんあります。これらの多くはドキュメントに記載されており(コンソールで ?tbl_summary と入力してください)、いくつかは 簡単な統計的検定のセクションに記載されています。
17.6 base R
関数 table() を使って、列の集計やクロス集計を行うことができます。上記のオプションとは異なり、以下のように、列名を参照するたびにデータフレームを指定する必要があります。
注意: 引数 useNA = "always" (“no” または “ifany” に設定することも可能)を含めない限り、NA (欠測値)値は集計 されません。
ヒント: magrittr の %$% を使用すれば、 ベース 関数でデータフレームの呼び出しを繰り返しする必要がなくなります。例えば、以下のように記述できます。 linelist %$% table(outcome, useNA = "always")
table(linelist$outcome, useNA = "always")
  Death Recover    <NA>
   2582    1983    1323
複数の列をカンマで区切って順番に並べることで、クロス集計が可能です。 オプションとして、Outcome = linelist$outcomeのように各列に「名前」を付けることもできます。
age_by_outcome <- table(linelist$age_cat, linelist$outcome, useNA = "always") # 表をオブジェクトとして保存
age_by_outcome   # 表を出力
        Death Recover <NA>
  0-4     471     364  260
  5-9     476     391  228
  10-14   438     303  200
  15-19   323     251  169
  20-29   477     367  229
  30-49   329     238  187
  50-69    33      38   24
  70+       3       3    0
  <NA>     32      28   26
割合
割合を取得するには、上記の表を関数 prop.table() に渡します。引数 margins = を使用して、行に対しての割合の場合は “1”、列に対しての場合は “2”、または表全体に対しての場合は “3” のいずれかを指定します。 わかりやすくするために、この表を base R の round() にパイプで渡し、2 桁の数字を指定します。
# 上で定義した表の割合を、行ごとに、丸めて取得
prop.table(age_by_outcome, 1) %>% round(2)
        Death Recover <NA>
  0-4    0.43    0.33 0.24
  5-9    0.43    0.36 0.21
  10-14  0.47    0.32 0.21
  15-19  0.43    0.34 0.23
  20-29  0.44    0.34 0.21
  30-49  0.44    0.32 0.25
  50-69  0.35    0.40 0.25
  70+    0.50    0.50 0.00
  <NA>   0.37    0.33 0.30
合計
行と列の合計を加えるには、テーブルを addmargins() に渡します。これは、数と割合の両方で機能します。
addmargins(age_by_outcome)
        Death Recover <NA>  Sum
  0-4     471     364  260 1095
  5-9     476     391  228 1095
  10-14   438     303  200  941
  15-19   323     251  169  743
  20-29   477     367  229 1073
  30-49   329     238  187  754
  50-69    33      38   24   95
  70+       3       3    0    6
  <NA>     32      28   26   86
  Sum    2582    1983 1323 5888
データフレームに変換
table() オブジェクトを直接データフレームに変換することは、簡単ではありません。以下にひとつの方法を示します。:
-
useNA = "always"を 使用せず にテーブルを作成します。代わりに forcats のfct_explicit_na()でNA値を “(Missing)” に変換します。 -
addmargins()にパイプ演算子で渡して合計値を追加します(オプション) -
base R の
as.data.frame.matrix()にパイプ演算子で渡します。 - 表を tibble 関数の
rownames_to_column()にパイプ演算子で渡し、最初の列の名前を指定します。 - 必要に応じて、出力、表示、またはエクスポートします。この例では、 見やすい表の作り方 の章で説明したように、flextable パッケージの flextable() を使用します。 こうすると、RStudio の viewer ペインにきれいな HTML イメージとして出力することができます。
table(fct_na_value_to_level(linelist$age_cat, level = "(Missing)"), fct_na_value_to_level(linelist$outcome, level = "(Missing)")) %>%
  addmargins() %>%
  as.data.frame.matrix() %>%
  tibble::rownames_to_column(var = "Age Category") %>%
  flextable::flextable()
Age Category |
Death |
Recover |
(Missing) |
Sum |
|---|---|---|---|---|
0-4 |
471 |
364 |
260 |
1,095 |
5-9 |
476 |
391 |
228 |
1,095 |
10-14 |
438 |
303 |
200 |
941 |
15-19 |
323 |
251 |
169 |
743 |
20-29 |
477 |
367 |
229 |
1,073 |
30-49 |
329 |
238 |
187 |
754 |
50-69 |
33 |
38 |
24 |
95 |
70+ |
3 |
3 |
0 |
6 |
(Missing) |
32 |
28 |
26 |
86 |
Sum |
2,582 |
1,983 |
1,323 |
5,888 |
17.7 参考資料
この章に掲載されている情報の多くは、これらのリソースやオンライン上のヴィネットを参考にしています。: